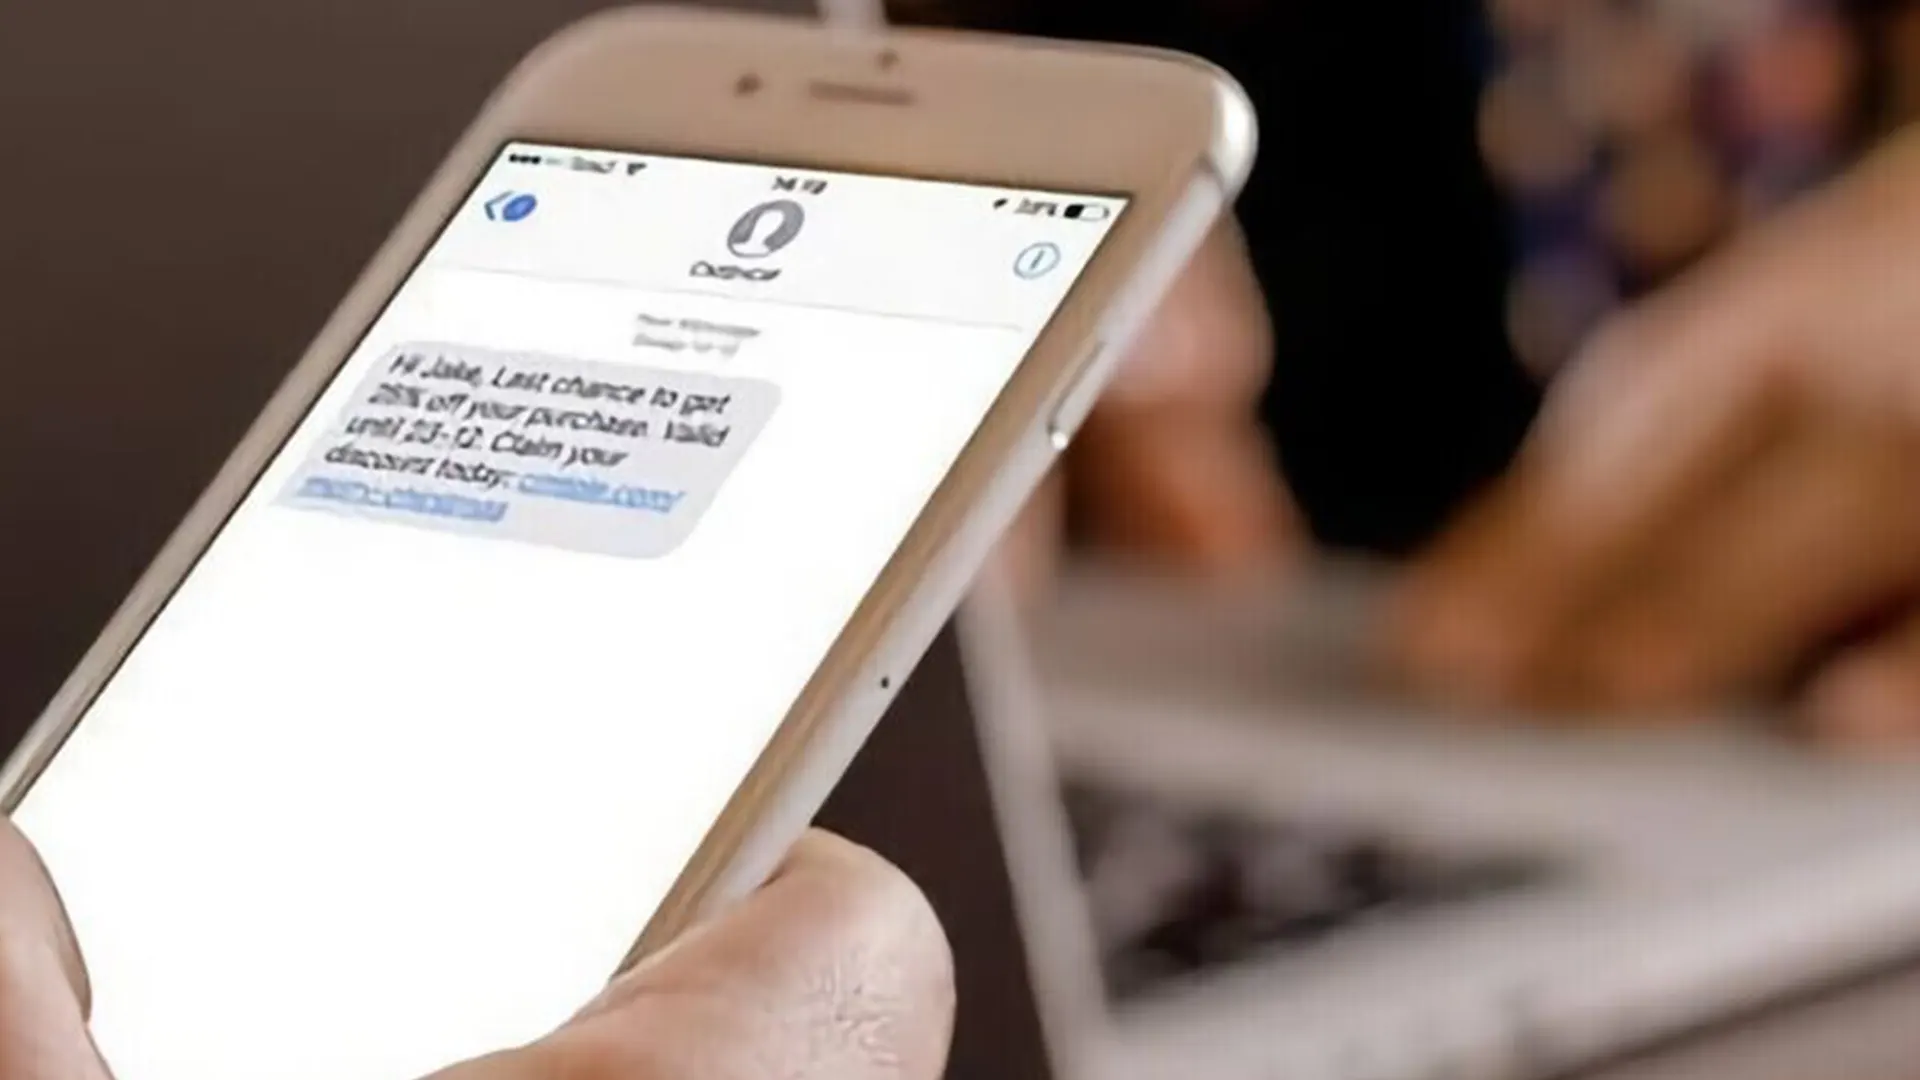
Um SMS promete um prêmio, exige uma resposta urgente e traz um link para resgate. O endereço parece legítimo, mas pode levar a uma página criada para roubar dados. Esse tipo de golpe que induz as pessoas a revelarem informações a um indivíduo ou grupo mal-intencionado que se passa por uma empresa legítima, é chamado de smishing.
Para enfrentar isso, a cientista de computação Stephane Schwarz desenvolveu em seu doutorado um modelo de inteligência artificial que combina diferentes informações para identificar mensagens fraudulentas. A tese, intitulada “Detecção de smishing em plataformas conversacionais: conciliando robustez de modelos e requisitos de indústria para detecção de conteúdo malicioso em SMS, MTT e RCS”, foi orientada por Anderson Rocha, coordenador do laboratório de inteligência artificial Recod.ai e docente do Instituto de Computação da Unicamp.
O SMS é utilizado por empresas para enviar avisos, cobranças, códigos de autenticação e ofertas aos seus clientes. Por não depender de internet e aplicativos, ter baixo custo e possibilidade de uso em massa, ele se tornou um meio de comunicação alvo de fraudadores.
O modelo de IA que combina diversas evidências contextuais que permitem analisar de forma mais robusta a legitimidade de determinada mensagem. Embora o foco seja o SMS, a metodologia é aplicável a canais como WhatsApp e Facebook Messenger.
O processo começa com o sistema olhando o endereço eletrônico. Ele analisa URLs para identificar padrões de caracteres e homóglifos (substituição de letras por símbolos visualmente semelhantes) para que sites falsos pareçam reais. Encurtadores de links também são verificados, além da consulta a bases de dados que permitem apurar domínios, proprietário e data de criação do site.
O Smish-Checker, em vez de verificar cada mensagem, faz um agrupamento delas baseado em semelhanças de estrutura e de significado, o que diminui o volume de dados analisado. Em um dos experimentos, o modelo agrupou 12 milhões de mensagens semelhantes em 17 mil grupos. O sistema ainda escolhe exemplos representativos de cada grupo para rotular se é fraude. Depois da classificação, o veredito é propagado para os demais dados com base nas relações de similaridade entre eles.